
csaw(ChIP-seq Analysis with Windows) 是 Bioconductor 中针对 ChIP-seq 差异结合分析(differential binding, DB)的 R 包,由 Lun 和 Smyth 开发,原始论文发表于 Nucleic Acids Research(2016)。
它的两个关键思路是:
- Sliding-window analysis:不一定先做 peak calling,而是将基因组划分成小窗口,直接比较不同样本的信号。
- Background-based TMM normalization:将基因组划分成较大的 bins(通常 10 kb),从大量背景区域估计样本间的 composition bias。
本文重点讨论第二种方法:当某种组蛋白修饰在药物处理后发生广泛变化时,如何避免把 ChIP-seq 的相对测序信号误读为真正的 gain?
1. csaw 解决什么问题?
传统 differential peak 分析通常先调用 peaks,再建立一套 consensus peaks,统计 reads,交给 DESeq2 或 edgeR 做差异分析。典型工具是 DiffBind。
csaw 提供另一种路径:
BAM(多个生物学重复)
    ↓
Sliding windows / genomic bins
    ↓
统计每个窗口的 reads/fragments
    ↓
低丰度窗口过滤
    ↓
Normalization(background bins TMM 等)
    ↓
edgeR:negative binomial GLM
    ↓
合并相邻显著 windows,控制 region-level FDR
    ↓
Differentially bound regions
Sliding windows 的好处是:可以更精细地定位局部的信号变化,减少对预先 peak calling 及 peak boundaries 的依赖。
但 csaw 不是只用于 sliding windows。它的 background TMM 也可以单独拿出来计算 normalization factors,再用于同一套 consensus peaks 的 DiffBind 分析。
2. 为什么 ChIP-seq 会出现归一化伪影?
测序得到的是 ChIP 文库中的相对 reads 分布,并不直接告诉我们每个细胞中某种 histone mark 的绝对总量。
假设 EPZ 抑制 DOT1L 后,大量 H3K79me2 富集区域的真实信号下降。即使两个样本最终都测序 20 million reads,文库中的构成也可能发生变化:
| 教学示例 | KO_DMSO | KO_EPZ |
|---|---|---|
| 有效测序 reads | 20 M | 20 M |
| 富集区域 reads 占比 | 80% | 40% |
| 其他区域 reads 占比 | 20% | 60% |
这只是假设性的组成变化示例,不是实际实验结果。
如果仅用总 reads 计算 CPM/RPM:
- 原本信号强的区域可能表现为下降;
- 部分变化不大或接近背景的区域可能因相对占比上升而出现 apparent gain;
- 这种正向 log2FC 不一定等于真实的局部修饰增加。
因此需要考虑 composition bias。但要注意:DESeq2 median-of-ratios、常规 TMM 与 CPM 并不是同一种归一化算法,其假设和失效情景不能混为一谈。
3. 什么是 Background TMM?
最核心的假设:
大部分大尺度 genomic bins 主要代表非差异背景区域。若这些背景区域在样本间存在一致的相对信号偏移,可以将其视为需要校正的文库组成偏差。
计算过程可以概括为:
Step 1  将基因组划分成 10 kb bins
Step 2  对每个 BAM 统计每个 bin 的 reads
Step 3  两两比较样本,计算各 bin 的 M-value 和 A-value
Step 4  TMM 丢弃 M、A 分布中极端的 bins
Step 5  估计样本之间的系统性 log-ratio
Step 6  计算各样本的 normalization factors
Step 7  将 factors 应用于后续窗口或 peaks 的差异分析
并不是先识别出所有“真正背景区域”再计算;实际做法是对大量全基因组 bins 计数,用 TMM 的 trimming 减少强富集/强差异 bins 的影响。
大窗口(例如 10 kb)有利于减少低计数导致的离散性,同时得到较稳定的背景估计。但没有任何单一 bin 宽度对所有实验都最佳,建议比较 5 kb、10 kb、20 kb 的稳定性。
4. M-value 怎么计算?
M = Minus:两个样本标准化 log2 信号之差。
以 KO_EPZ 为 sample、KO_DMSO 为 reference,第 i 个 10 kb bin 的 M-value 为:
\[M_i=\log_2\left( \frac{Y_{i,\mathrm{EPZ}}/N_{\mathrm{EPZ}}} {Y_{i,\mathrm{DMSO}}/N_{\mathrm{DMSO}}} \right)\]其中:
- Y:对应 bin 的 reads/fragment count;
- N:样本的 library size;
- i:genomic bin 编号。
假设两个样本各有 20 million reads,在某个 bin 中:
| KO_DMSO | KO_EPZ | |
|---|---|---|
| Bin counts | 400 | 200 |
| CPM | 20 | 10 |
那么:
\[M=\log_2(10/20)=-1\]解释:
- M = 0:两个样本的相对信号相同;
- M = +1:sample 是 reference 的 2 倍;
- M = −1:sample 是 reference 的 0.5 倍。
这里的 M 是按照测序深度计算的相对值,不是绝对 histone modification fold change。
5. A-value 怎么计算?
A = Average:两个样本标准化 log2 信号的平均值,描述 bin 的整体丰度。
\[A_i=\frac{1}{2}\left[ \log_2\left(\frac{Y_{i,\mathrm{EPZ}}}{N_{\mathrm{EPZ}}}\right) + \log_2\left(\frac{Y_{i,\mathrm{DMSO}}}{N_{\mathrm{DMSO}}}\right) \right]\]若采用 CPM 表示丰度,上例中:
\[A=\frac{\log_2(10)+\log_2(20)}{2}\approx3.82\]A 越大,代表这个 bin 在两样本中的平均相对丰度越高。
注意:将 reads/library size 改写为 CPM,会使 A 整体增加常数 log2(10^6),但 M 不变。真实算法对零计数还需做数值处理,以上公式用于说明基本思想。
6. MA plot 与 TMM 的真正关系
MA plot 的每个点代表一个 genomic bin:
- X 轴:A-value(平均 log2 丰度);
- Y 轴:M-value(样本间 log2 比值)。
TMM(Trimmed Mean of M-values)的流程是:
- 计算每个 bin 的 M 和 A;
- 去掉 M 两端的极端值(可能存在 differential binding 的 bins);
- 再去掉 A 两端的极端值(丰度极端的 bins);
- 根据保留 bins 的 M-values 估计系统性偏移,并转成 scaling factors。
普通 TMM 可做 precision weighting,使高计数区域占更大权重。但 csaw::normFactors() 默认关闭 precision weighting,因为高丰度 bins 更可能包含真正的结合/修饰区域,若它们未被 trimming 完全排除,给予过大权重反而不利于估计背景。
因此,Background TMM 的目标不是“使所有 peak 的 log2FC 都等于 0”,而是让假设相对稳定的背景区域不再呈现系统性偏移。
作为诊断,建议同时画校正前后的 10 kb bin-level MA plot:检查主背景点云是否接近 0、是否存在异常分层、低计数离散和显著 A-dependent trend。简单的单一 scaling factor 不能消除复杂的非线性偏差。
7. TMM normalization factor 怎么作用到 reads 上?
在 edgeR 的统计模型中:
\[N_{\mathrm{effective},j} = N_{\mathrm{library},j}\times f_{\mathrm{TMM},j}\]例如:
| Sample | Library size | TMM factor | Effective size |
|---|---|---|---|
| KO_DMSO | 20 M | 0.90 | 18 M |
| KO_EPZ | 20 M | 1.11 | 22.2 M |
这组数字纯属教学示例,不是实际估计值。
factor 越大,有效文库大小越大;对于固定的原始 counts,模型中的标准化相对信号会越小。
要分清三种量:
- Raw library size:有效测序 reads/fragments 的数量;
- TMM normalization factor:用于校正文库组成的相对系数;
- Effective library size:模型实际使用的 library size × factor。
TMM factor 不是 spike-in scaling factor,也不是 DESeq2 中可直接无条件照搬的 sizeFactor。若要应用于 DESeq2,需要结合一致口径的 library sizes 构造相对 size factors,并检查工具的接口和归一化方向。
8. R 中怎样计算 10 kb Background TMM?
下面是 csaw 官方流程的精简版。将自己的 BAM 路径填入 bam.files:
library(csaw)

# BAM files for biological replicates; paths must exist.
bam.files <- c(
  "KO_DMSO_rep1.bam",
  "KO_DMSO_rep2.bam",
  "KO_DMSO_rep3.bam",
  "KO_EPZ_rep1.bam",
  "KO_EPZ_rep2.bam",
  "KO_EPZ_rep3.bam"
)

# Apply the same filtering parameters to all BAM files.
param <- readParam(minq = 20)

# Count fragments/reads over genome-wide 10 kb bins.
binned <- windowCounts(
  bam.files,
  bin = TRUE,
  width = 10000,
  param = param
)

# Estimate relative background TMM factors.
nf <- normFactors(binned, se.out = FALSE)

data.frame(
  sample = basename(bam.files),
  library_size = binned$totals,
  norm_factor = nf,
  effective_library_size = binned$totals * nf
)
要点:
minq = 20只是示例;paired-end、duplicates、异常染色体和 blacklist 的处理要与下游差异分析口径协调。- csaw 使用同一套
readParam分别对大 bins 和小 windows 计数时,得到的 library-size 定义才有可比性。 normFactors(binned, se.out = FALSE)返回数值向量;如果要在 csaw 中进一步分析小窗口,也可以用normFactors(binned, se.out = window_data)将因子写入后续对象,前提是两套数据的 library sizes 一致。- 对多个 marks,通常应分别计算 TMM factors,不能把 K79me2 的因子直接用于 K27me3 或 K36me2。
csaw 官方教程:The csaw Book — Normalizing for technical biases。
9. 案例:NSD1 KO + EPZ 的 H3K79me2
以下为此前分析中 group_scale_factor_summary.tsv 提供的组间相对归一化因子摘要(以各 mark 的 KO_DMSO 为 1),不是本文重新读取 BAM 后计算的结果。
| Mark | WT_DMSO | KO_DMSO(reference) | KO_EPZ |
|---|---|---|---|
| K27me3 | 0.978 | 1.000 | 0.996 |
| K36me2 | 0.977 | 1.000 | 0.997 |
| K79me2 | 1.016 | 1.000 | 1.301 |
| Menin | 1.004 | 1.000 | 1.014 |
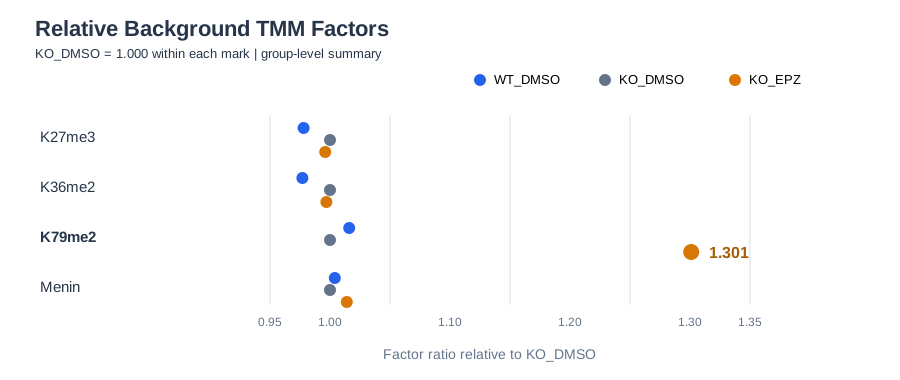
图:依据上述组间摘要数值绘制,不是 36 个样本的 replicate-level factor 图。每种 mark 分别将 KO_DMSO 设为 1;这些数值不可直接理解为修饰绝对含量。
最明显的现象是 K79me2 的 KO_EPZ/KO_DMSO factor ratio 约为 1.301,而 K27me3、K36me2、Menin 的比值接近 1。
对应的 log2 因子差异:
\[\log_2(1.301)\approx0.379\]若只讨论归一化因子引入的调整项,KO_EPZ 相对于 KO_DMSO 的标准化 log2 ratio 将额外减去约 0.379:
\[\Delta \log_2(\mathrm{normalized\ ratio}) = -\log_2(f_{\mathrm{EPZ}}/f_{\mathrm{DMSO}}) \approx-0.379\]这里假定使用的是同一套 factors、同一 library-size 口径,且不混入其他 normalization offsets。这不是 KO_EPZ 的真实 H3K79me2 log2FC,也不是“全局信号下降 30.1%”。
如果某些 K79me2 gain loci 的 positive log2FC 很小,那么这种系统性校正可能改变它们的效应量,甚至改变是否通过统计阈值。但具体多少 gain peaks 消失,必须重新对固定的 consensus peaks 进行统计检验,不能由 1.301 直接推算。
10. csaw 与 DiffBind 应该怎么配合?
| 比较 | csaw 完整流程 | DiffBind 常见流程 |
|---|---|---|
| 分析单位 | Sliding windows,再合并 regions | 预定义 consensus peaks |
| 事先需要 peaks? | 不必须 | 通常需要 |
| 差异模型 | edgeR | DESeq2 或 edgeR |
| Background TMM | 可直接由 10 kb bins 估计 | 可应用适当的背景归一化策略/自定义因子 |
| 结果定位 | 更灵活的局部 DB regions | 固定 peaks,更利于两套策略直接对照 |
对当前问题,没必要因为使用 csaw 的归一化就完全放弃 DiffBind。
更直接的比较是:固定同一套 K79me2 consensus peaks 与原始 counts,保持 Input 处理、过滤、blacklist、design、FDR 和 FC 阈值一致,只改变 normalization strategy。
可对照:
- DiffBind 原有 normalization;
- 10 kb background-bin TMM 的归一化结果;
- 必要时做 5 kb、20 kb bins 的敏感性分析。
这样可以回答:原来 KO_EPZ vs KO_DMSO 的 K79me2 gain peaks 有多少属于 normalization-sensitive gains?
推荐的输出与检查图
- Sample-level factor plot:显示 4 marks × 3 groups × 3 replicates,共 36 个样本的 factor 与组内分布,检查重复是否一致;
- Group-level relative factor plot:使用各 mark 的 KO_DMSO 为 reference,观察 K79me2 是否特别突出(上图);
- 10 kb background MA plots:对 KO_EPZ vs KO_DMSO 展示校正前、校正后的 M-value 分布;
- Mapped vs effective library sizes:判断哪些样本的 effective size 出现明显调整;
- MA/volcano + log2FC distribution:在相同 consensus peaks 上比较两种 normalization 的统计结果;
- Replicate-level tracks / counts:重点检查 apparent gain loci 是否接近背景、是否受到个别重复样本驱动。
数据要求:factor TSV 只能画 factor 图;若要画真实 background-bin MA plot,还需要 10 kb bin count matrix(或从 BAM 重新统计)。不能把从某些 peaks 得到的 log2FC 当作 background MA plot。
11. 三个最容易误解的地方
11.1 TMM 不是 spike-in
TMM 是基于样本自身测序数据及“多数参考区域相对稳定”的假设估计相对缩放因子。
Spike-in 则需要实验阶段加入可追踪且用量受控的外源参考。没有 spike-in 或其他外部定量尺度时,background TMM 不能单独证明每个细胞的 H3K79me2 绝对总量下降。
11.2 背景 bins 不一定真的稳定
如果 EPZ 广泛改变背景信号、抗体/IP 效率或 ChIP 文库的组成,TMM 的背景参考假设也可能受到破坏。因子显著偏离 1 只能提示数据组成存在变化,不能单独判断这种变化是技术性的还是生物学性的。
尤其需要把广泛相对变化与每细胞绝对变化区分开来。
11.3 Factor > 1 不是生物学上调
K79me2 KO_EPZ 的 1.301 是相对于 KO_DMSO 的 normalization factor ratio,其数学意义是归一化时改变有效文库大小,而不是 KO_EPZ 的 H3K79me2 修饰上调 30.1%。
若问题是“EPZ 是否使 H3K79me2 绝对降低”,还需 Western blot、定量质谱或经过恰当设计的外源参考校准等证据。
12. 实际分析应保存的 metadata
为了保证以后比较不同 normalization 策略时可重复,建议每次都记录:
target = K79me2
comparison = KO_EPZ_vs_KO_DMSO
bin_width = 10000
counting_unit = reads_or_paired_end_fragments
MAPQ_cutoff = 20
duplicate_filter = [actual setting]
library_size_definition = [actual setting]
blacklist = [file and version]
input_control = [condition-matched input and settings]
normalization = csaw_background_bin_TMM
normFactors_weighted = FALSE
peak_universe = [consensus BED path]
universe_peak_count = [actual number]
summits = [actual setting]
count_filter = [actual setting]
differential_method = [DESeq2/edgeR]
FDR_cutoff = [actual threshold]
FC_or_log2FC_cutoff = [actual threshold]
R_version = [sessionInfo()]
csaw_version = [packageVersion("csaw")]
DiffBind_version = [packageVersion("DiffBind")]
date = 2026-10-20
方括号处必须填运行时的实际参数,不能直接视为已执行配置。
13. 小结
csaw Background TMM 可以浓缩为一句话:
不从可能广泛变化的 peaks 中寻找标尺,而是利用全基因组大量 10 kb bins 估计相对稳定的背景标尺,再校正后续差异分析。
对 NSD1 KO + EPZ 的 H3K79me2 项目而言,它最直接的用途是检验原先的 gain/loss peaks 有多依赖归一化方式,而不是仅凭一个 TMM factor 给出“全局修饰升降”的绝对定量结论。
参考文献与资料
- Lun ATL, Smyth GK. csaw: a Bioconductor package for differential binding analysis of ChIP-seq data using sliding windows. Nucleic Acids Research. 2016;44(5):e45. DOI: 10.1093/nar/gkv1191 · PMC 全文。重点:Normalization of library-specific biases。
- Robinson MD, Oshlack A. A scaling normalization method for differential expression analysis of RNA-seq data. Genome Biology. 2010;11:R25. DOI: 10.1186/gb-2010-11-3-r25。TMM 原始统计方法。
- Lun ATL, Smyth GK. From reads to regions: a Bioconductor workflow to detect differential binding in ChIP-seq data. F1000Research. 2015/2016;4:1080. DOI: 10.12688/f1000research.7016.2。
- csaw 官方教程:The csaw Book — Chapter 5: Normalizing for technical biases。重点:5.2 Eliminating composition biases 与 5.2.3 Visualizing normalization with MA plots。
- csaw 函数说明:normFactors()。
注:本文的 M/A 计数示例和有效文库大小示例均为教学数据;组间 1.301 等因子来自此前提供的摘要,而非本文新运行的计算。